
Il backup su più zone di sicurezza dovrebbe preservare i confini di fiducia imposti dalla rete di produzione. Utilizzare credenziali specifiche per zona, flussi di rete con ambito ristretto, separazione tra traffico di controllo e traffico dati e percorsi di ripristino indipendenti. Laddove sia vietata la connettività persistente tra zone, ricorrere alla replica controllata, al trasferimento unidirezionale o a supporti offline, anziché indebolire la segmentazione della rete.
La presente nota è destinata agli architetti di infrastruttura e sicurezza e agli amministratori senior impegnati nell’architettura di backup aziendale in ambienti deliberatamente segmentati, quali difesa, aerospaziale, ricerca, tecnologia operativa, infrastrutture critiche e aziende che gestiscono reti attraverso diversi livelli di classificazione o domini di fiducia. Questi possono essere domini di rete classificati e non classificati, tecnologia informatica aziendale contrapposta alla tecnologia operativa in ambito produttivo e configurazioni simili.
L’attenzione è rivolta alle conoscenze relative al backup e alla risoluzione di un problema di progettazione. Nello specifico, questa nota riguarda la protezione delle zone senza creare nuovi percorsi tra di esse.
Punti chiave
- Il backup multizona dovrebbe preservare i confini esistenti delle zone di sicurezza.
- Utilizzare credenziali privilegiate specifiche per zona e regole firewall con ambito ristretto.
- Separare il traffico di controllo del backup dal traffico dei dati di backup.
- Mantenere la capacità di ripristino locale laddove le zone devono operare in modo indipendente.
- Testare il ripristino in assenza di connettività tra le zone, identità centralizzate e cataloghi condivisi.
Perché il backup è difficile su più zone di sicurezza?
Le architetture di backup centralizzate possono creare rischi strutturali per la sicurezza in ambienti segmentati. Spesso si basano su una connettività persistente e su privilegi elevati oltre i confini delle zone, il che può trasformare il sistema di backup in un potenziale percorso per il movimento laterale.
Le architetture di backup centralizzate, come le suite di backup aziendali con console unica e le architetture centralizzate di tipo “pull” basate su appliance, presuppongono che il server di backup raggiunga ogni client, che i client restituiscano i dati allo storage condiviso e che tutti possano accedere al piano di gestione.
Tale presupposto funziona in una rete piatta. Tuttavia, non funziona in ambienti deliberatamente segmentati, come le reti tattiche militari, gli enclavi di ricerca nel settore della difesa e gli ambienti industriali di tecnologia operativa, controllo di supervisione e acquisizione dati (SCADA).
Il backup tra zone di sicurezza dovrebbe preservare gli ambienti con segmentazione di rete imposta. Quando il backup collega la zona IT aziendale a un ambiente ingegneristico soggetto a restrizioni, la segmentazione inizia a giocare a sfavore del sistema di backup.
Il traffico di backup complica la situazione. Nello specifico, ciò si riferisce a connessioni di grandi dimensioni, regolari e autenticate che attraversano i confini delle zone secondo una pianificazione prevedibile. Inoltre, si riferisce alle credenziali degli account di servizio con privilegi elevati su entrambe le estremità e alle copie archiviate di tutto ciò che viene toccato.
Quando un componente di backup viene compromesso, consente l’accesso a dati provenienti da zone che non sarebbero raggiungibili attraverso la rete di produzione.
A partire da ottobre 2026, la norma NIST SP 1339 (giugno 2026) raccomanda di creare regolarmente backup OT, testarli e rivederli durante le esercitazioni di ripristino.
Perché l’infrastruttura di backup può creare un rischio interzonale?
Un server di backup dotato di connessioni autorizzate a più zone può comunicare tra tali zone tramite percorsi consentiti. Quando il server viene compromesso, i canali autorizzati esistenti raggiungono ogni zona servita. E ciò è causato dalla posizione, non da una configurazione errata.
Perché è necessario definire i confini di fiducia prima di scegliere un software di backup?
Mappare i confini di fiducia, la direzione delle connessioni consentite e i percorsi di comunicazione vietati prima di scegliere o configurare i prodotti di backup. Innanzitutto, progettare l’architettura; poi, il prodotto si adatterà ad essa.
L’architettura Zero Trust del NIST descrive l’eliminazione della fiducia implicita basata semplicemente sulla posizione di rete. Guida rapida al backup OT del NIST (SP 1339) è la guida rapida al backup delle tecnologie operative (OT) pubblicata dal National Institute of Standards and Technology (NIST) e dal National Cybersecurity Center of Excellence (NCCoE). Questa guida sottolinea che le organizzazioni dovrebbero stabilire procedure chiare per il backup e il ripristino in caso di ransomware.
L’architettura Zero Trust del NIST (SP 800-207) è una pubblicazione ufficiale del National Institute of Standards and Technology che definisce l’architettura Zero Trust (ZTA) e fornisce linee guida affinché la sicurezza informatica possa abbandonare le tradizionali difese di rete basate sul perimetro.
Non viene concessa alcuna fiducia implicita basata esclusivamente sulla posizione fisica o di rete. Ecco una fonte governativa autorevole che tratta delle copie di ripristino protette/offline/immutabili.
Un errore comune è quello di stabilire prima le relazioni di fiducia e solo successivamente scegliere una piattaforma di backup.
Le funzionalità del prodotto, quali la deduplicazione e la compressione inline globali, gli snapshot multi-cloud e l’orchestrazione degli array di storage, sono meno essenziali rispetto alla comprensione di quali comunicazioni siano consentite tra le zone. I prodotti di backup non possono ignorare una regola del firewall correttamente applicata.
- Prima di qualsiasi configurazione di backup, identificare le zone di sicurezza e il loro livello di classificazione.
- Successivamente, definire quali sistemi possono connettersi con altri.
- Successivamente, separate il traffico del piano di controllo da quello del piano dati durante l’esecuzione delle analisi.
- Inoltre, individuate i luoghi in cui è consentita la presenza delle credenziali.
- Infine, mappate i percorsi vietati in cui la progettazione del backup può operare.
La posizione delle credenziali è una decisione relativa ai confini di fiducia. Un account di servizio di backup con accesso in lettura ai sistemi della Zona C non dovrebbe esistere su un sistema connesso alla Zona A.
L’ambito e la posizione delle credenziali rappresentano decisioni relative ai confini di fiducia.
Riferimento alle linee guida rivisto nell’ottobre 2026: NIST SP 800-207, pubblicato nell’agosto 2020.
Quali modelli di architettura di backup funzionano su più zone di sicurezza?
I modelli non sono universalmente validi. Il modello corretto dipende dai livelli di classificazione, dai percorsi di comunicazione consentiti, dai requisiti di ripristino e dai costi operativi necessari per l’isolamento di ciascuna zona. Il backup multizona non dovrebbe creare nuovi percorsi di accesso tra le zone.
Esistono cinque modelli consolidati che consentono di eseguire il backup oltre i confini delle zone, come ad esempio la rete informatica aziendale rispetto all’impianto industriale di tecnologia operativa e gli enclave di produzione generici nel cloud rispetto agli ambienti di elaborazione dei pagamenti conformi allo standard PCI-DSS (Payment Card Industry Data Security Standard).
Ciascuno di essi rappresenta un compromesso tra semplicità operativa e isolamento di sicurezza.
| Modello | Descrizione | Ideale per | Rischio principale |
|---|---|---|---|
| Centralizzato | Un unico server di backup utilizza regole firewall interzonali per servire tutte le zone | Zone con livelli di sensibilità variabili ma con lo stesso livello di affidabilità | Un unico punto di compromissione con accesso autorizzato a tutte le zone |
| Completamente distribuito | Ogni zona dispone di un proprio server di backup, storage e catalogo. I dati non attraversano i confini delle zone. | Ambienti in cui i dati rimangono sempre all’interno della propria zona. | Duplicazione dell’infrastruttura; complica il ripristino tra zone |
| Gerarchica | Infrastruttura di backup a livello di zona con replica opzionale verso un repository centrale tramite un gateway controllato. L’infrastruttura di backup non dovrebbe indebolire i confini di fiducia esistenti. | Ambienti che richiedono il ripristino locale e la conservazione centralizzata | Il gateway diventa un obiettivo interzonale di alto valore, ovvero un gateway critico per la sicurezza con accesso a più zone. |
| Replica controllata | Backup locale alla zona; i dati vengono trasferiti tramite un gateway, un diodo di dati o un’apertura programmata del firewall. Un diodo di dati è un dispositivo di sicurezza di rete basato su hardware che consente la trasmissione unidirezionale dei dati tra due reti. | Ambienti in cui sono vietate le connessioni persistenti di backup tra zone | La finestra di trasferimento funge da superficie di attacco se non sottoposta a un controllo rigoroso. La superficie di attacco è costituita dai sistemi, dai servizi e dai percorsi di rete che un aggressore potrebbe potenzialmente sfruttare. |
| Completamente separato | I componenti non sono condivisi a nessun livello. Presenta server, storage, cataloghi, percorsi di amministrazione e procedure di ripristino separati. | Requisiti di isolamento assoluto; separazione tra informazioni classificate e non classificate | Costo operativo più elevato; capacità di backup con duplicazione completa |
Da quale parte dovrebbe essere avviata la connessione di backup?
La direzione preferita della connessione dipende dal confine di fiducia. Nelle zone con lo stesso livello di fiducia, può essere opportuno utilizzare connessioni Bacula standard avviate dal Director. Nelle zone soggette a restrizioni, una connettività in entrata ridotta può comportare una riduzione della superficie di attacco autorizzata, e la configurazione Bacula selezionata dovrebbe essere supportata e testata.
In un’implementazione Bacula convenzionale, il Director stabilisce connessioni sia con il File Daemon (sul client) che con lo Storage Daemon (sulla destinazione di archiviazione). Il flusso di dati di backup transita tra il File Daemon e lo Storage Daemon. Il Director non si trova nel percorso dei dati.
Negli ambienti in cui le zone hanno lo stesso livello di fiducia e il Director può stabilire connessioni in entrata verso i client, il modello standard può funzionare senza necessità di modifiche.
Quando un confine di zona non consente connessioni in entrata provenienti dalla rete di backup, la connessione standard avviata dal Director verso il File Daemon potrebbe non disporre dell’autorizzazione necessaria.
Bacula supporta la connettività avviata dal File Daemon tramite la configurazione ConnectToDirector. Verificate la disponibilità e il comportamento in base alla versione di Bacula implementata nel vostro ambiente, riducendo i requisiti di accesso in entrata nella zona soggetta a restrizioni. Ciò richiede una pianificazione e dei test specifici, che riguardano anche la pianificazione e il comportamento del controllo dei processi.
In che modo la direzione della connessione di backup influisce sul rischio interzonale?
Il rischio di pivot è il rischio di utilizzare una connessione di backup autorizzata per raggiungere un’altra zona. Da quale parte dovrebbe essere avviata la connessione di backup?
Se il Director stabilisce connessioni con i client della Zona C utilizzando una regola autorizzata, un Director compromesso dispone già di un percorso consentito verso la Zona C. Se i File Daemon della Zona C stabiliscono connessioni in uscita, tale superficie di ingresso viene ridotta. Il firewall controlla ciò che può essere tenuto sotto controllo, mentre l’architettura determina ciò che è autorizzato.
La connettività bidirezionale attraverso un confine di zona consente al numero di percorsi di connessione interzona consentiti di aumentare in entrambe le direzioni. Requisiti operativi specifici dovrebbero giustificare l’adozione di regole firewall bidirezionali associate al traffico di backup attraverso un confine ad alta sensibilità, senza lasciarle come predefinite.
Come si impedisce all’infrastruttura di backup di creare un percorso tra zone?
Un server di backup connesso a più zone può instradare il traffico tra di esse utilizzando le proprie interfacce. È possibile impedirlo ricorrendo a controlli espliciti a livello di rete, interfacce separate per ogni zona, disabilitando l’instradamento tra interfacce e riducendo al minimo l’impronta dei servizi.
Un server di backup dotato di connessioni autorizzate a più zone funge da ponte tra di esse. Il server utilizza il routing, non una configurazione errata. Se il traffico della Zona B e della Zona C arriva su interfacce diverse, il routing tra di esse dovrebbe essere disabilitato o regolato da una politica specifica.
Ogni zona dovrebbe disporre di un’interfaccia di rete separata. Ridurre al minimo i servizi sull’infrastruttura di backup. Considerare ciascuno di essi come una superficie di attacco aggiuntiva.
L’amministrazione dovrebbe avvalersi di un percorso di gestione dedicato senza attraversare le reti delle zone di produzione.
Come dovrebbero essere separati il controllo del backup e il traffico dati?
L’architettura di Bacula è progettata strutturalmente per separare il piano di controllo e il piano dati. Il piano di controllo trasporta il traffico relativo alla gestione dei lavori e all’orchestrazione. Il piano dati trasporta i dati di backup e ripristino.
Il Director mantiene sotto controllo la pianificazione e l’orchestrazione dei lavori senza trasportare i dati di backup. Il File Daemon invia i dati allo Storage Daemon. Non c’è alcun Director nel percorso dei dati.
Ciò ha implicazioni specifiche per il firewall: le connessioni Director→File Daemon (TCP 9102) e Director→Storage Daemon (TCP 9103) trasportano il controllo dei processi. Il percorso File Daemon→Storage Daemon trasporta il flusso di backup.
È possibile limitare l’accesso della console di gestione al Director (TCP 9101) a una rete di gestione dedicata senza influire sui flussi di dati di backup.
Il Director può rimanere nella zona di backup utilizzando regole ristrette per le zone di produzione (solo orchestrazione dei processi). Le regole dello Storage Daemon regolano separatamente il percorso dei dati a volume più elevato.
Quando si utilizza un’unica regola generica per entrambi, il valore architettonico della separazione viene meno. Il traffico di gestione, compreso l’accesso alla console e le query sul catalogo, dovrebbe transitare attraverso un percorso dedicato. Non dovrebbe transitare attraverso interfacce condivise con i dati di backup.
Tabella di riferimento dei flussi del firewall
| Origine | Destinazione | Porta predefinita | Scopo | Direzione |
| Console | Director | TCP 9101 | Gestione | Console → Director |
| Director | File Daemon | TCP 9102 | Controllo dei processi | Director → FD |
| Director | Daemon di archiviazione | TCP 9103 | Controllo archiviazione | Director → SD |
| File Daemon | Storage Daemon | TCP 9103 | Dati di backup | FD → SD |
Come dovrebbero essere isolate le credenziali di backup tra le zone di sicurezza?
Utilizzare credenziali di backup privilegiate separate per le zone di sicurezza. Assicurarsi che la compromissione delle credenziali in una zona non fornisca automaticamente l’accesso autenticato a un’altra.
Gli account di servizio di backup nella Zona C dovrebbero essere diversi da quelli della Zona B e della Zona A. Quando le credenziali sono condivise, una singola compromissione può estendere l’accesso autenticato a tutte le zone che utilizzano tali credenziali.
Le dipendenze di ripristino da un’infrastruttura di identità centralizzata, come Active Directory, LDAP (Lightweight Directory Access Protocol) e provider di identità (IdP) esterni, rappresentano un comune punto di fallimento dell’architettura. Gli IdP sono sistemi centralizzati come Okta, Microsoft Entra ID o Google Identity che gestiscono gli account utente, le autenticazioni e le autorizzazioni di accesso.
Se la Zona C viene autenticata tramite il provider di identità della Zona A, la Zona A può aiutare la Zona C a ripristinarsi. Gli account di servizio locali con credenziali gestite in modo indipendente eliminano tale dipendenza.
Utilizzate una pianificazione specifica per ruotare le credenziali degli account di servizio di backup. Rispondete alla domanda «È possibile ripristinare la Zona C con un provider di identità centrale offline?» prima che si verifichi un incidente.
Come devono essere trasferiti i dati di backup tra le zone di sicurezza?
Scegliere il meccanismo di trasferimento in base al livello di sensibilità della zona. Una zona con restrizioni implica che il meccanismo di trasferimento debba ridurre al minimo la propria superficie di rete persistente. Nello specifico, ciò si riferisce al trasferimento diretto tramite gateway e aperture a tempo limitato, nonché a supporti fisici offline laddove un percorso di rete tra zone sia vietato o inaccettabile.
Quando i dati di backup devono attraversare il confine di una zona per motivi di conservazione o di ripristino di emergenza, il metodo di trasferimento fa parte dell’architettura di sicurezza.
Il trasferimento diretto tramite una regola autorizzata del firewall è l’opzione più semplice. Tuttavia, crea un percorso persistente con regole che specificano indirizzi e porte esatti. Queste regole devono essere registrate.
Un gateway controllato può limitare l’impatto di una compromissione quando le destinazioni, i protocolli e le funzioni consentite sono rigorosamente limitati.
Lo “store-and-forward” con aperture del firewall a tempo limitato preserva la capacità di ripristino locale, indipendentemente dal fatto che la finestra di trasferimento sia aperta o meno.
Il trasferimento offline su supporto fisico evita una connessione di rete tra le zone di origine e di destinazione durante il trasferimento. Le zone altamente isolate potrebbero accettare solo questa opzione. Le zone isolate dovrebbero disporre di un percorso di ripristino definito quando i servizi condivisi sono offline.
I dati di backup dovrebbero essere crittografati prima di attraversare un confine di zona. Nessuno dovrebbe poter accedere alle chiavi di decrittografia al di fuori della zona di origine.
Perché il ripristino tra zone può essere più difficile del backup?
Anche se la progettazione riesce a scrivere correttamente i dati di backup tra le zone, il processo potrebbe fallire durante il ripristino di emergenza. Il ripristino si basa su un ambiente di destinazione funzionante, servizi di identità, connettività di rete e un catalogo operativo. Queste dipendenze possono impedire il ripristino anche quando i dati di backup stessi sono intatti. Il ripristino deve essere testato in assenza delle dipendenze tra zone.
L’integrità della zona è anche associata al ripristino. Nello specifico, se i dati della Zona C vengono ripristinati nella Zona A, il modo in cui i dati hanno lasciato la propria zona potrebbe non soddisfare i requisiti del confine. L’integrità della zona e l’integrità dei dati non sono gli stessi vincoli.
Rispondete a queste domande prima che si verifichi un incidente:
- Se non c’è connettività tra le zone, ogni zona può ripristinarsi in modo indipendente?
- Se il catalogo di backup non è disponibile, il ripristino può procedere da supporti offline?
- È stato definito e testato il backup locale delle credenziali per il ripristino nel caso in cui i servizi di identità centrali non fossero disponibili?
- Lo storage locale è sufficientemente aggiornato per consentire un ripristino efficace con un firewall interzonale chiuso?
- I siti possono funzionare e ripristinarsi in modo indipendente senza una rete geografica (WAN)?
Qual è la differenza tra disponibilità del backup e recuperabilità?
La scrittura riuscita sull’archivio è considerata disponibilità. Quando i dati vengono ripristinati correttamente nella zona giusta, tramite un’autenticazione funzionante, entro il tempo richiesto, con il firewall interzona chiuso e l’identità centrale offline, si parla di recuperabilità. È essenziale concentrarsi sulla progettazione e sul collaudo della recuperabilità, non solo della disponibilità.
Un sistema che scrive sul dispositivo di archiviazione è considerato disponibile. Un sistema è considerato recuperabile quando utilizza un’autenticazione funzionante per ripristinare i dati corretti nella zona corretta, in una destinazione funzionante, entro il tempo richiesto e con il firewall interzonale chiuso e l’identità centrale offline. Si tratta di proprietà diverse. La seconda deve essere testata.
Come si presenta un’architettura di backup a tre zone?
Questo scenario riguarda una progettazione multizona coerente in cui la capacità di ripristino delle zone corrisponde al loro livello di isolamento. Nello specifico, la Zona A dipende dalla Zona di backup, mentre la Zona B esegue il ripristino localmente o dalla Zona di backup. La Zona C esegue il ripristino da componenti locali senza dipendere da sistemi esterni.
L’architettura di riferimento seguente illustra un progetto multizona coerente. La Zona C è isolata, quindi non dispone di percorsi di rete in entrata o in uscita verso zone esterne. Le funzioni del piano di controllo e del piano dati sono locali alla Zona C. I dati escono tramite trasferimento su nastro fisico.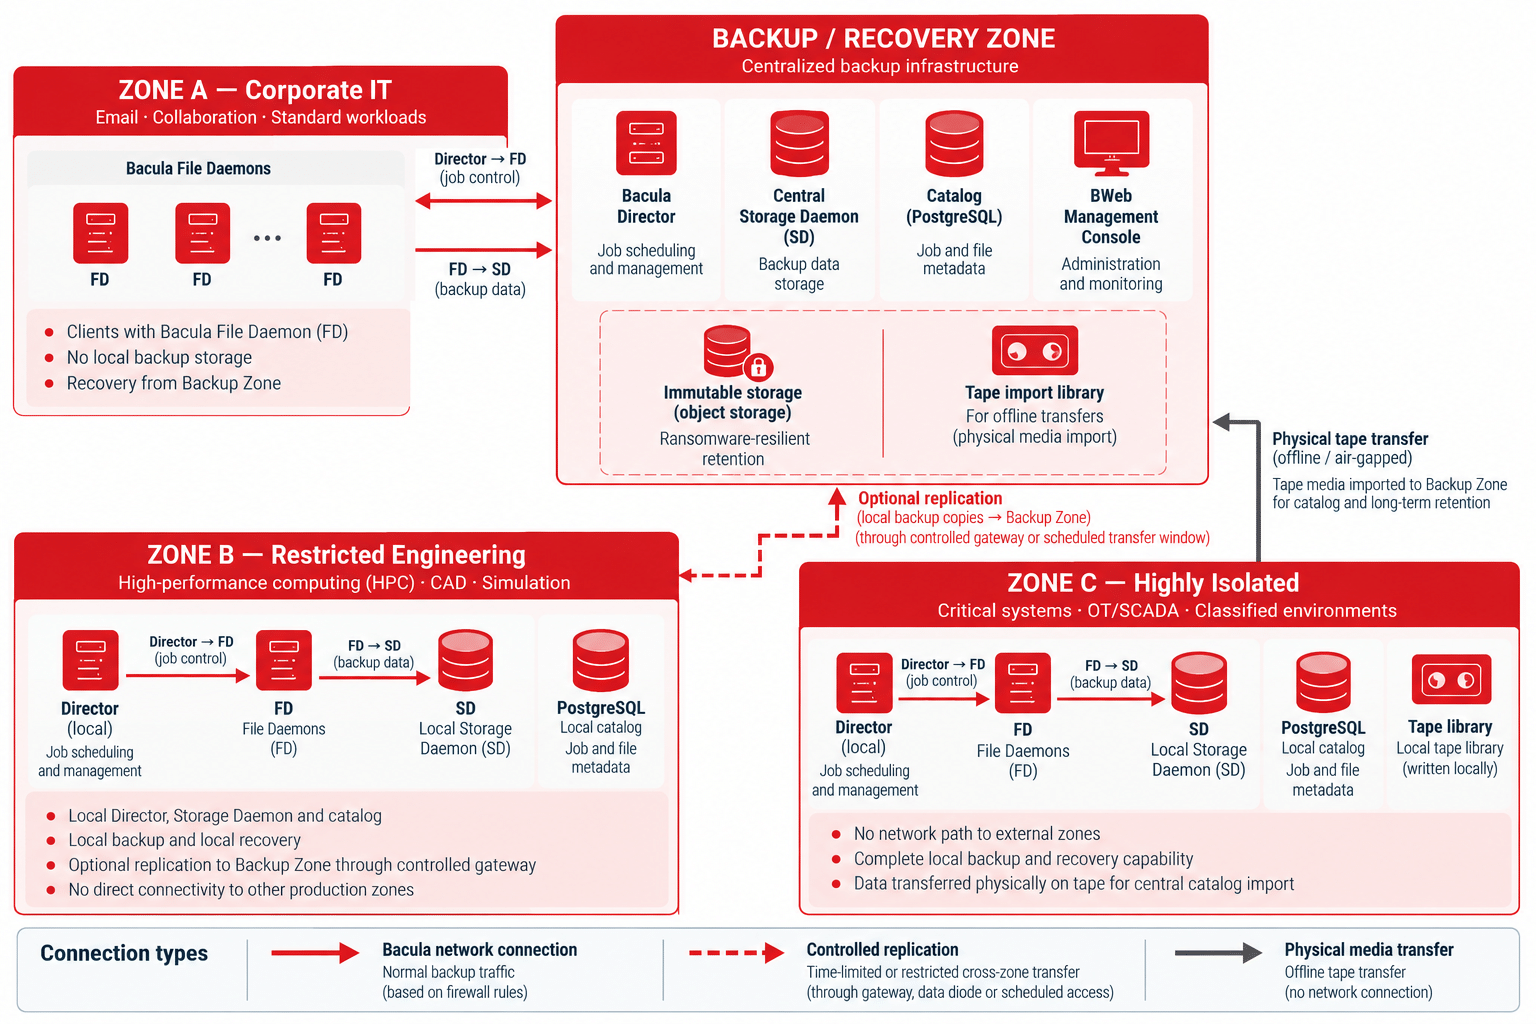
Per “air-gapped” si intende un supporto di backup fisicamente scollegato, privo di una connessione di rete attiva. Non si tratta di uno storage isolato logicamente dalla rete.
Una replica del catalogo rappresenta una copia sincronizzata di alcuni o di tutti i record del catalogo primario, conservata su un’istanza di database separata.
Zona A: IT aziendale
I File Daemon trasferiscono i dati in uscita verso lo Storage Daemon centrale. Il Director utilizza un percorso autorizzato attraverso il firewall per pianificare i processi. Non è presente uno spazio di archiviazione locale per i backup. Quando è disponibile la connettività, la Zona A può eseguire il ripristino dalla Zona di backup.
Zona B: Ingegneria con accesso limitato
La Zona B protegge cluster di calcolo ad alte prestazioni, carichi di lavoro di simulazione, dati di progettazione assistita da computer e set di dati di ricerca. Ospita un Director Bacula locale, i File Daemon, lo Storage Daemon e il catalogo, consentendo il backup e il ripristino senza connettività alla Zona centrale di backup/ripristino.
I dati di backup vengono trasferiti localmente dai daemon di file al daemon di archiviazione della zona, mentre il Director locale gestisce i processi di backup e ripristino. Le copie di backup possono essere replicate nella zona centrale di backup/ripristino tramite un gateway controllato durante le finestre di trasferimento autorizzate. Se la connettività tra le zone non è disponibile, la Zona B può continuare le operazioni locali di backup e ripristino.
Zona C: Altamente isolata
Nessun percorso di rete verso zone esterne. La Zona C ospita il proprio Director, i File Daemon, lo Storage Daemon, il catalogo e la libreria a nastro. Un processo sottoposto a controllo trasferisce fisicamente il nastro alla Zona di backup per l’importazione nel catalogo centrale. La Zona C esegue il ripristino dal proprio Storage Daemon locale senza servizi di identità esterni né connettività di rete.
Zona di backup/ripristino
Qui risiedono il Director centrale, lo Storage Daemon, il catalogo e la console di gestione. Accetta connessioni di backup dalle Zone A e B. Nessun instradamento tra le zone di produzione. Conservazione resistente al ransomware tramite archiviazione di oggetti immutabili. La conservazione resistente al ransomware è l’archiviazione di backup progettata per resistere a cancellazioni o modifiche non autorizzate.
La libreria a nastro consente la conservazione a lungo termine e l’importazione nella Zona C. L’amministrazione si avvale di un’interfaccia di gestione dedicata non raggiungibile dalle reti delle zone di produzione.
Come scegliere un’architettura di backup multizona?
Questa tabella aiuta a confrontare le opzioni nelle principali dimensioni di progettazione. Ogni riga rappresenta una decisione indipendente. Le scelte non devono necessariamente essere uniformi in tutte le dimensioni.
Come progettare un backup multizona in 7 passaggi
| Domanda di progettazione | Opzione A | Opzione B | Opzione C |
|---|---|---|---|
| Infrastruttura di backup | Centralizzata: un unico server, tutte le zone | Specifica per zona: dedicata per ogni zona | Ibrida: Director centrale, archiviazione a livello di zona |
| Direzione della connessione | Avviata dal server: il backup viene scaricato dai client | Avviata dal client: i client inviano i dati all’archiviazione | Mista: varia in base alla sensibilità della zona |
| Archiviazione di backup | Centralizzata: tutte le zone scrivono su un’archiviazione condivisa | Per zona: ogni zona conserva i propri dati | A più livelli: copia locale più replica centrale |
| Trasferimento tra zone | Diretto: regola firewall permanente | Gateway: trasferimento a tempo limitato | Offline: supporto fisico, nessun percorso di rete |
| Amministrazione | Condivisa: un’unica console raggiunge tutte le zone | Segmentata: percorsi separati per zona | Completamente isolata: nessuna infrastruttura amministrativa condivisa |
| Copia di ripristino finale | Disco immutabile: online, protetto in scrittura | Archiviazione a oggetti con blocco degli oggetti. Il blocco degli oggetti riguarda il controllo della conservazione che impedisce che i dati di backup vengano modificati o eliminati durante un periodo di protezione definito, indipendentemente dal fornitore. | Nastro / offline: fisicamente isolato |
| Identità per il ripristino | Centralizzata: dipende da Active Directory e da un provider di identità esterno | Account locali: credenziali preparate in anticipo | Mista: primaria centralizzata, di riserva locale |
A quali guasti dovrebbe resistere un’architettura di backup multizona?
Esaminate gli scenari di guasto rispetto all’architettura progettata prima di implementare il software. Gli scenari con risposte poco chiare o negative rappresentano una lacuna di progettazione che dovreste risolvere prima che si verifichi un incidente.
| Scenario di guasto | Domanda di progettazione |
|---|---|
| Rete aziendale compromessa | Le zone B e C possono continuare a eseguire il backup e il ripristino in modo indipendente? La compromissione della zona A offre un punto di accesso alla zona di backup? |
| Server di backup compromesso | Un aggressore può stabilire connessioni con le zone di produzione? Le copie di backup sono immutabili, in modo da non poter essere eliminate? |
| Una zona diventa irraggiungibile | Le zone rimanenti possono continuare a eseguire il backup e il ripristino? L’indisponibilità di una zona influisce sui cataloghi delle altre zone? |
| Infrastruttura di identità offline | Le operazioni di backup e ripristino possono autenticarsi senza il provider di identità centrale? |
| Firewall interzonale chiuso | Ogni zona può ripristinarsi in modo indipendente dall’archivio locale? Il catalogo locale è sufficientemente aggiornato? |
| Archivio primario distrutto | Esiste una seconda copia su un supporto diverso in una sede diversa? Qual è il tempo di ripristino dalla copia secondaria? |
| Catalogo di backup non disponibile | È possibile procedere al ripristino da supporti offline senza l’ausilio del catalogo? La procedura è documentata e testata? |
Cosa occorre verificare prima di implementare un backup multizona?
Questa lista di controllo è fondamentale per la revisione del progetto. Le voci non spuntate rappresentano delle lacune che è necessario colmare prima che l’architettura possa essere considerata completa.
- In primo luogo, occorre documentare i confini di fiducia e le classificazioni delle zone; solo successivamente si può procedere alla progettazione dell’architettura di backup.
- Un componente compromesso nella Zona B non può raggiungere la Zona C attraverso canali di backup autorizzati o regole del firewall.
- Gli account dei servizi di backup sono isolati per ciascuna zona. Nessuna credenziale privilegiata condivisa attraversa i confini tra le zone.
- Le regole del firewall relative al backup specificano con esattezza origine, destinazione, porte e direzione.
- Le zone possono eseguire il backup e il ripristino localmente in assenza di connettività tra le zone.
- Almeno una copia di ripristino è collocata al di fuori della rete di produzione: archiviazione online immutabile o supporti offline.
- Non è necessario disporre dell’infrastruttura o dei servizi di identità di un’altra zona per ripristinare ciascuna zona.
- Le procedure di ripristino vengono testate, inclusi gli scenari in cui il catalogo non è disponibile.
- Vengono testate le credenziali di riserva locali per il ripristino in assenza del provider di identità centrale. Le credenziali locali sono credenziali predisposte in anticipo, utilizzabili quando non sono disponibili servizi di identità centralizzati.
- Il traffico di backup che attraversa i confini delle zone viene registrato sul firewall. Le anomalie sono sottoposte a monitoraggio.
In che modo Bacula supporta il backup attraverso più zone di sicurezza?
La separazione tra Director, Storage Daemon e File Daemon di Bacula va oltre la semplice comodità operativa. Si tratta di una caratteristica architettonica che consente di collocare componenti diversi in zone diverse con regole firewall distinte. In questo modo, essi possono supportare i modelli di progettazione multizona descritti in questa nota.
L’architettura di backup di Bacula Enterprise offre un modello a componenti distribuiti che si adatta naturalmente a più zone. Gli utenti possono implementare in modo indipendente il Director, lo Storage Daemon e il File Daemon. I diversi componenti possono risiedere in zone diverse con regole firewall diverse. Questa separazione dei componenti consente modelli di implementazione che allineano i singoli servizi Bacula a diverse zone di sicurezza.
La documentazione sulla configurazione del File Daemon di Bacula descrive la comunicazione tra il Director e lo Storage Daemon per il backup dei file sui client.
Un unico Director nella zona di backup può gestire i File Daemon in più zone. I File Daemon locali fungono da endpoint del percorso dati nelle zone. I dati fluiscono direttamente tra il File Daemon e lo Storage Daemon senza passare attraverso il Director. Ecco perché i requisiti del firewall del Director rimangono più limitati. Il posizionamento dello Storage Daemon può seguire la sensibilità della zona senza dipendere dalla posizione del Director.
Per le zone in cui non esiste un percorso di rete accettabile verso la zona di backup, Bacula supporta nastri e supporti offline come destinazioni locali della zona. In particolare, uno Storage Daemon scrive localmente e il nastro viene trasferito fisicamente per l’importazione nella zona di backup senza la necessità di un percorso di rete tra le zone.
Le opzioni di archiviazione immutabile di Bacula, tra cui il blocco degli oggetti e i nastri WORM (Write Once, Read Many), possono proteggere le copie di backup opportunamente configurate da cancellazioni o modifiche non autorizzate.
Il backup immutabile e il ripristino da ransomware sono importanti quando si ha a che fare con una zona di produzione compromessa, dalla quale un aggressore potrebbe tentare di cancellare o modificare le copie di ripristino accessibili.
Per gli ambienti HPC in zone soggette a restrizioni, Bacula supporta Lustre, IBM General Parallel File System (GPFS) e file system paralleli su larga scala. Non sono necessarie modifiche per l’isolamento delle zone.
I componenti vengono eseguiti in loco senza fare affidamento su infrastrutture esterne di gestione cloud. Verificare le licenze e le dipendenze dai servizi esterni in relazione al proprio ambiente prima di utilizzare il software.
Il comportamento del prodotto Bacula e le opzioni di implementazione supportate devono essere verificati in base alla versione implementata. I riferimenti tecnici contenuti in questa nota sull’architettura sono stati rivisti nell’ottobre 2026.
Principio chiave dell’architettura
Il backup multizona deve preservare la sicurezza dei confini dell’ambiente di produzione. L’infrastruttura di backup non dovrebbe consentire accessi tra zone vietati dall’architettura di produzione. Progettare flussi consentiti, credenziali e percorsi di ripristino indipendenti, e solo successivamente decidere dove distribuire i componenti di Bacula.
Domande frequenti
Un singolo server di backup può proteggere in modo sicuro più zone di sicurezza?
Potenzialmente sì. Un server di backup centralizzato può essere appropriato laddove le zone condividano requisiti di fiducia compatibili e le sue connessioni consentite, le credenziali e i controlli di instradamento non creino rischi inaccettabili tra le zone.
I client di backup dovrebbero avviare le connessioni?
Nelle zone soggette a restrizioni, sì. Le connessioni in uscita avviate dai client riducono la superficie di attacco in entrata attraverso i canali di backup verso quella zona.
L’archiviazione immutabile sostituisce il backup offline?
No. L’immutabilità protegge i dati di backup da modifiche o cancellazioni nell’ambito di controlli di conservazione definiti, ma di per sé non garantisce l’isolamento di rete. Il backup offline interrompe la connessione di rete attiva mentre l’archiviazione rimane offline. Si tratta di protezioni distinte che affrontano rischi diversi e possono essere utilizzate insieme.
Una zona isolata può utilizzare un’identità centralizzata?
Sì, se tale dipendenza è accettabile durante il ripristino. Se il ripristino dipende da quel provider di identità e non esiste un’autenticazione locale di riserva, la perdita del provider può impedire il ripristino.
Bacula può eseguire il backup di una zona senza una connessione di rete persistente?
Sì. Un demone di archiviazione locale scrive su nastro all’interno della zona. Il nastro viene trasferito fisicamente e importato nel catalogo centrale.


